ModellerAraştırmaFiyat ve erişim
Artificial Analysis, yapay zekâ sıralamasını gizli testlerle yeniledi: Intelligence Index v5
Endeksin yüzde 60’ı artık gizli test sorularına dayanıyor. Açık ve kapalı modeller arasındaki fark 3 puandan 12 puana çıktı.
Instagram gönderisinin kapağı.
Kaynaklar: Artificial Analysis, Interconnects
Endeks baştan kuruldu
Bağımsız değerlendirme şirketi Artificial Analysis, en çok alıntılanan yapay zekâ sıralaması Intelligence Index’in 5. sürümünü 27 Ekim’de yayımladı. Şirket bunu, Ocak’ta çıkan 4. sürümden bu yana en büyük güncelleme olarak tanımlıyor. İlk kez endeksin çoğunluğu, yüzde 60’ı, özel test setlerine ya da cevapları gizli tutulan sorulara dayanıyor. Aynı gün, 2022’den bu yana çıkan dil modellerini tek bir yetenek ölçeğine yerleştiren Progress Index v1 de yayımlandı.
 Artificial Analysis@ArtificialAnlys
2 yeni test ve 3 yükseltmeyle gelen Artificial Analysis Intelligence Index v5'i duyuruyoruz. İlk kez endeksin çoğunluğu özel veri setlerine dayanıyor
Artificial Analysis Intelligence Index, bugünkü gerçek kullanımı yansıtan görevlerde model yeteneklerini ölçen birleşik ölçütümüz. v5, Ocak'ta çıkan v4'ten bu yana en büyük güncellememiz. v5 ile endeksin %60'ı artık özel test setleri ya da gizli tutulan cevaplarla yapılan değerlendirmelere dayanıyor.
Intelligence Index v5 ile birlikte, model yeteneğini zaman içinde tek ve sürekli bir ölçekte izleyen Artificial Analysis Progress Index v1'i de başlatıyoruz.
Intelligence Index'e yeni eklenenler:
➤ FrontierCode 2.0: Cognition'ın yeni çıkardığı, gerçek dünya kodlama görevlerinden oluşan özel test; ajanın değişikliğini bir depo sorumlusunun birleştirip birleştirmeyeceğine göre puanlanıyor
➤ Terminal-Bench-Science: terminal ortamında çalışan 70 ajan tabanlı bilimsel araştırma görevi
Yükseltilenler:
➤ HLE-Diamond (Humanity's Last Exam'in yerine): akıl yürütme ve bilgi soruları arasında eşit bölünmüş, 1.000 soruluk rafine bir Humanity's Last Exam sürümü
➤ AA-Omniscience v1.1: doymuş ve herkese açık sorular çıkarılmış, yeni sorular eklenmiş, belirsiz ya da hatalı sorular düzeltilmiş güncel veri seti
➤ CritPt v2: CritPt yazarlarınca düzeltilen ve kod çalıştırma aracıyla yürütülen, CritPt v2'nin 40 soruluk özel zor alt kümesi
Endekste kalanlar: AA-Briefcase, AutomationBench-AA, GDP.pdf ve Terminal-Bench 4.0
Endeksten çıkarılanlar: GDPval-AA v2.1, SciCode ve AA-LCR v1.1
Öne çıkan sonuçlar:
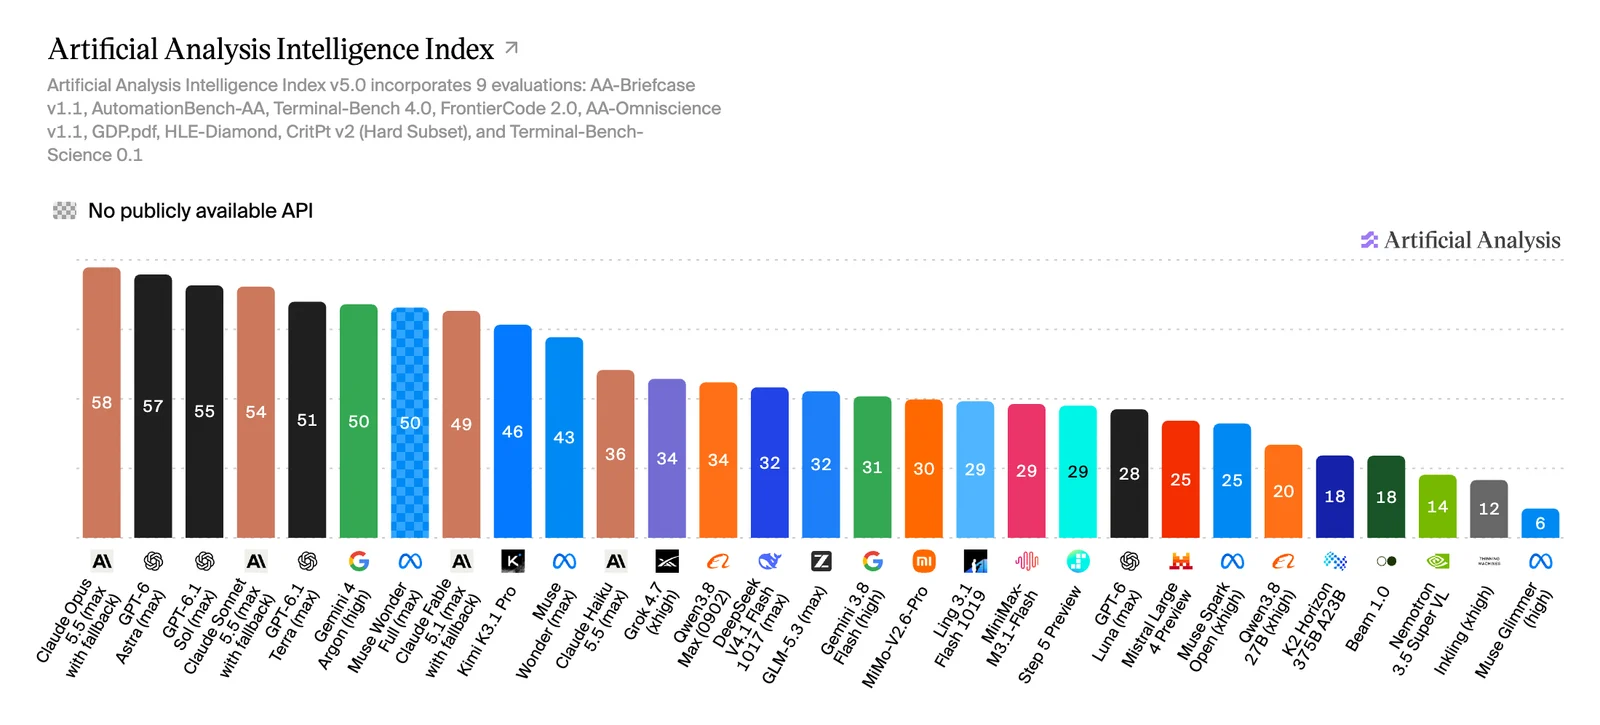
➤ Claude Opus 5.5 (max) 58 puanla GPT-6 Astra (max, 57) ve GPT-6.1 Sol'un (max, 55) önünde lider: ilk beş model Anthropic ve OpenAI'ın. Sonraki sırada 50 puanla Gemini 4 Argon (high) var
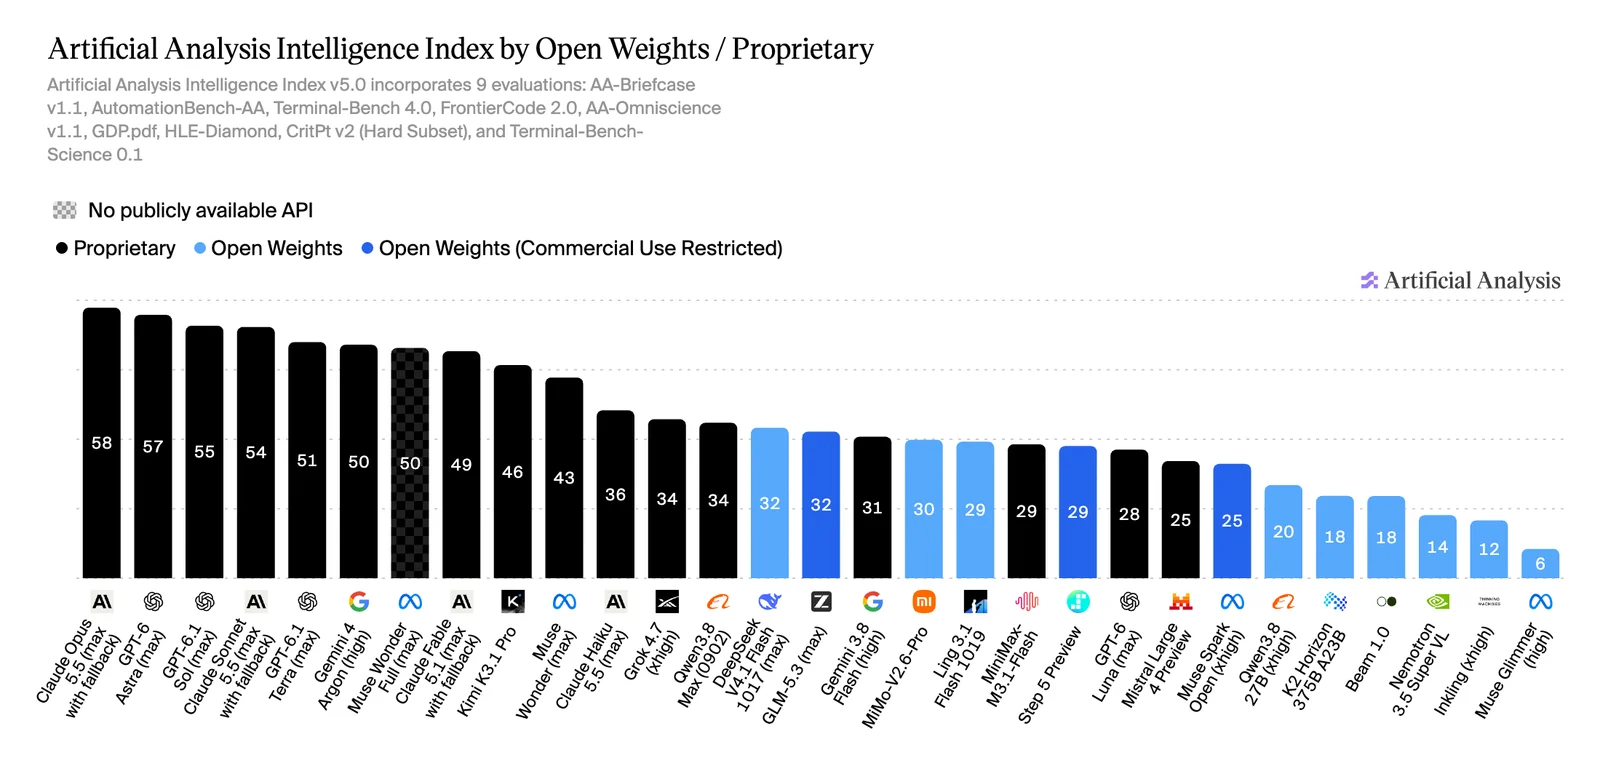
➤ Açık ağırlıklı modellerle fark 3 puandan 12'ye çıktı: en iyi açık ağırlıklı model 46 puanla Kimi K3.1 Pro (ağırlıkları henüz yayımlanmadı). Ağırlıkları yayımlanmış modellerde DeepSeek V4.1 Flash 1017 (max) ve GLM-5.3 (max) 32 puanla önde; liderin 26 puan gerisinde ve Claude Haiku 5.5'in (max, 36) altında
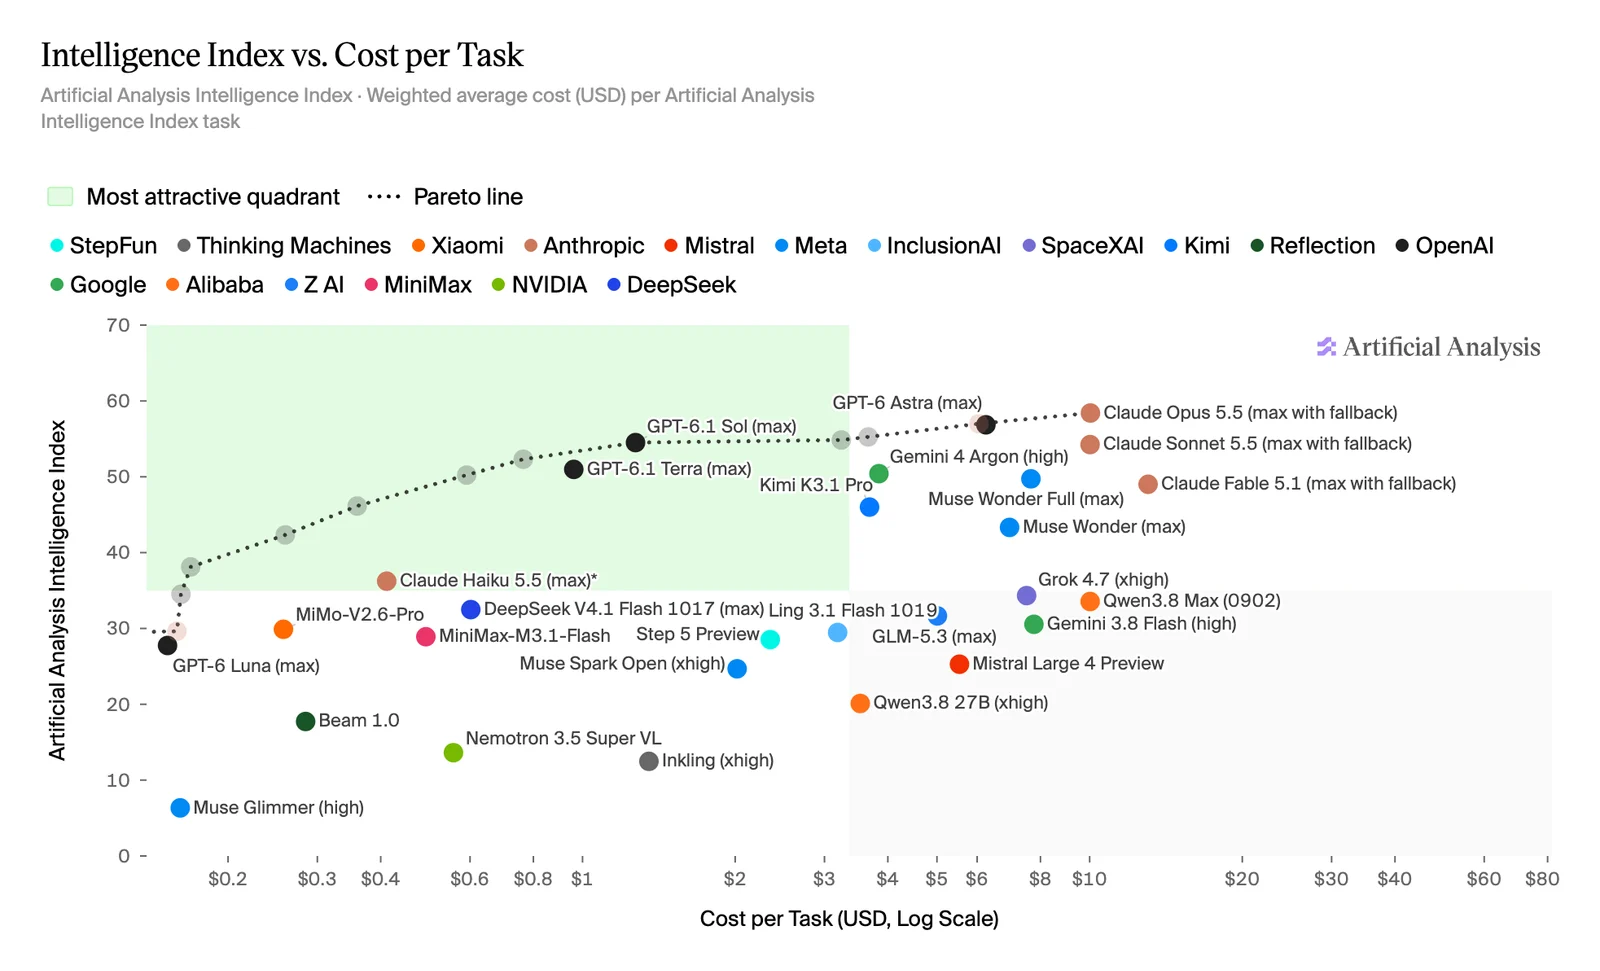
➤ Görev başına maliyet önde gelen modeller arasında 13 kattan fazla değişiyor: gösterilen en yüksek puanlı 10 model içinde Intelligence Index görevi başına 0,96 dolarla en ucuzu GPT-6.1 Terra (max), 13,04 dolarla en pahalısı Claude Fable 5.1 (max)Announcing Artificial Analysis Intelligence Index v5, featuring 2 new benchmarks and 3 upgrades. For the first time, the majority of the Index is built on private datasets
The Artificial Analysis Intelligence Index is our composite measure of model capabilities across tasks reflecting real-world usage today. v5 is our biggest upgrade since v4 launched in January. With v5, 60% of the Index is now based on evaluations with private test sets or held-out answers.
Alongside Intelligence Index v5, we’re launching the Artificial Analysis Progress Index v1, which tracks model capability over time on one continuous scale.
New to the Intelligence Index:
➤ FrontierCode 2.0: Cognition's newly-launched private benchmark of real-world coding tasks, graded on whether a repository maintainer would merge the agent's change
➤ Terminal-Bench-Science: 70 agentic scientific research tasks, run in a terminal environment
Upgraded:
➤ HLE-Diamond (replacing Humanity's Last Exam): a refined 1,000-question version of Humanity's Last Exam, split evenly between reasoning and knowledge questions
➤ AA-Omniscience v1.1: An updated dataset with saturated and public set questions removed, new questions added, and ambiguous or erroneous questions revised
➤ CritPt v2: a private, 40-question hard subset of CritPt v2, revised by the CritPt authors and run with a code-execution tool
Staying in the Index: AA-Briefcase, AutomationBench-AA, GDP.pdf and Terminal-Bench 4.0
Removed from the Index: GDPval-AA v2.1, SciCode, and AA-LCR v1.1
Key results:
➤ Claude Opus 5.5 (max) leads at 58, ahead of GPT-6 Astra (max, 57) and GPT-6.1 Sol (max, 55): Anthropic and OpenAI hold the top five models. Gemini 4 Argon (high) is next at 50
➤ The open weights gap widens from 3 points to 12: Kimi K3.1 Pro (weights not yet released) is the top open weights model at 46. Among released weights, DeepSeek V4.1 Flash 1017 (max) and GLM-5.3 (max) lead at 32 - 26 points behind the leader and below Claude Haiku 5.5 (max, 36)
➤ Cost per task varies by more than 13x among the leading models: of the 10 highest-scoring models shown, GPT-6.1 Terra (max) is the cheapest at $0.96 per Intelligence Index task and Claude Fable 5.1 (max) the most expensive at $13.04
İngilizceden çevrildi

Açılıştaki sıralama ve Gemini 4 Carbon
Açılışta Claude Opus 5.5 58 puanla birinciydi. Onu GPT-6 Astra 57, GPT-6.1 Sol 55, Claude Sonnet 5.5 54 ve GPT-6.1 Terra 51 puanla izledi; ilk beş sırayı Anthropic ve OpenAI paylaştı. Gemini 4 Argon 50 puanda kaldı. Ertesi gün Google’ın tanıttığı Gemini 4 Carbon, 59 puanla birinci sıraya yerleşti.
Dört eşit kategori, dokuz test
Endeks dört kategoriden oluşuyor ve her biri yüzde 25 ağırlıkta. Bilgi işi kategorisinde AA-Briefcase (yüzde 15), AutomationBench-AA (yüzde 5) ve GDP.pdf (yüzde 5) var. Kodlamada FrontierCode 2.0 (yüzde 15) ve Terminal-Bench 4.0 (yüzde 10), bilimde Terminal-Bench-Science (yüzde 15) ve CritPt v2’nin zor alt kümesi (yüzde 10) yer alıyor. Genel kategoride AA-Omniscience v1.1 (yüzde 15) ve HLE-Diamond (yüzde 10) bulunuyor.
İki test yeni. Cognition’ın geliştirdiği FrontierCode 2.0, ajanın kod değişikliğini bir proje sorumlusunun birleştirip birleştirmeyeceğine göre puanlıyor; görevler, test verisinin modellere sızmaması için gizli tutuluyor. Terminal-Bench-Science ise terminal ortamında çalışan 70 bilimsel araştırma görevinden oluşuyor. Humanity’s Last Exam’in yerini, akıl yürütme ve bilgi soruları arasında eşit bölünmüş 1.000 soruluk HLE-Diamond aldı. AA-Omniscience’tan doymuş ve herkese açık sorular çıkarıldı; CritPt v2’nin 40 soruluk zor alt kümesi kod çalıştırma aracıyla ölçülüyor. GDPval-AA v2.1, SciCode ve AA-LCR v1.1 endeksten çıkarıldı.
Test bazında liderler farklı. FrontierCode 2.0’da Claude Opus 5.5 yüzde 46, HLE-Diamond’da yine Opus 5.5 yüzde 68 ile önde. Terminal-Bench-Science’ta GPT-6 Astra yüzde 63, CritPt v2’de yüzde 72 ile birinci. Terminal-Bench 4.0’da Kimi K3.1 Pro yüzde 67, AutomationBench-AA’da Gemini 4 Argon yüzde 78 ile ilk sırada.
Açık modellerle fark açıldı
Yeni sürümde ağırlıkları açık modeller belirgin biçimde geriledi. En iyi açık model ile lider arasındaki fark, önceki sürümde 3 puanken şimdi 12 puan. Listedeki en iyi açık model Kimi K3.1 Pro 46 puanda, ancak ağırlıkları henüz yayımlanmadı. Ağırlıkları yayımlanmış modellerde DeepSeek V4.1 Flash 1017 ve GLM-5.3 32 puanla önde; bu, liderin 26 puan gerisi ve Claude Haiku 5.5’in (36) da altı.
Maliyet 13 kattan fazla değişiyor
En yüksek puanlı 10 model arasında, endeksteki görev başına maliyet 13 kattan fazla değişiyor. En ucuzu 0,96 dolarla GPT-6.1 Terra, en pahalısı 13,04 dolarla Claude Fable 5.1. Claude Opus 5.5’in en yüksek ayardaki maliyeti 10,04 dolar, düşük ayarda ise 0,98 dolar. GPT-6 Astra 6,24, GPT-6.1 Sol 1,27 dolar. Modellerin görev başına ürettiği çıktı token’ının ortancası da 4.3 sürümündeki 35 binden 59 bine çıktı.
Eleştiri: gizli testler ve güven
Araştırmacı Nathan Lambert, Interconnects’teki yazısında endeksi “topluluk için inanılmaz derecede yararlı ve son derece kusurlu” diye niteledi. Lambert’e göre gizli sorular modellerin teste göre eğitilmesini zorlaştırıyor, ancak topluluğun test hatalarını bulmasını da engelliyor; böylece “gizli testi hazırlayana tam güven” gerekiyor. Lambert ayrıca Artificial Analysis’in iş modelinin laboratuvarlardan sonuçlarını doğrulama karşılığı ücret almak olduğunu hatırlatıyor ve bunu bir güven meselesi olarak görüyor. Ona göre tek bir zekâ endeksi yerine farklı ağırlıkları olan birden çok endeks gerekiyor.
Kaynaklar
4 kaynak
- “Artificial Analysis Intelligence Index v5”Yeni sürümün yöntemi, testleri, ağırlıkları, açılış sonuçları ve maliyetler; sayfadaki grafikler · artificialanalysis.ai
- Duyuru gönderisi ve sonuç özeti · x.com
- “Gemini 4 Carbon (High)”Gemini 4 Carbon’un 59 puanla birinci sıraya yerleşmesi · artificialanalysis.ai
- “Artificial Analysis v5 and the benchmarker’s dilemma”Gizli testler, güven ve iş modeli üzerine eleştiri · interconnects.ai
Bu haber hakkında
- Hazırlayan
- Yiğit Kasap · JARRUS
- Haber tarihi
- Sitede
- 29 Ekim 2026’dan beri
- @jarrus.ai hesabında 29 Ekim 2026’da paylaşıldı.
- Kısa link
thejarrus.com/intelligence-index-v5- Hata bildir
- Bu haberde bir hata mı var? [email protected] · Instagram